


Ostatnia aktualizacja: 2026-07-26
Ewaluacja systemów AI to nie pojedynczy wynik benchmarku, lecz proces sprawdzania, czy aplikacja spełnia zdefiniowaną jakość na realistycznych danych, przy akceptowalnym ryzyku, koszcie i opóźnieniu. W praktyce ewaluacja systemów AI łączy publiczne benchmarki, prywatny test set i monitoring po wdrożeniu.
Tekst ma charakter edukacyjny i opisuje proces oceny jakości systemów AI. Nie jest audytem bezpieczeństwa, certyfikacją modelu, poradą prawną ani gwarancją zgodności z RODO, AI Act lub wymaganiami konkretnej branży. W przykładach należy używać danych zanonimizowanych lub syntetycznych, jeżeli nie ma podstawy prawnej i polityki retencji dla danych produkcyjnych.
Wynik w benchmarku wygląda kusząco, bo daje jedną liczbę. Model A ma lepszy wynik niż model B, więc wybór wydaje się prosty. W praktyce aplikacja AI rzadko jest samym modelem. Ma prompt, system pobierania kontekstu, integracje, filtry bezpieczeństwa, limity kosztu, interfejs użytkownika, reguły eskalacji i ludzi, którzy później oceniają wynik pracy. Dlatego dobra ewaluacja systemów AI zaczyna się od pytania: co dokładnie ma być dobre?
Inaczej ocenia się klasyfikator wykrywający nadużycia, inaczej asystenta odpowiadającego na pytania z dokumentacji, a jeszcze inaczej agenta, który może wywołać narzędzie i zmienić dane w systemie. W artykule o różnicy między agentami AI i chatbotami kluczowe było rozdzielenie interfejsu rozmowy od pętli działania. Tu podobna zasada dotyczy oceny: nie mierzymy nazwy produktu, tylko zachowanie systemu w zdefiniowanych warunkach.
Najbezpieczniej myśleć o ewaluacji jako o łańcuchu: zdefiniuj zadanie, zbuduj test set, ustal metryki, uruchom baseline, przeanalizuj błędy, popraw system, zamroź holdout, czyli held-out test, i monitoruj produkcję. Benchmark nie zastępuje test setu. Test set nie zastępuje monitoringu. Judge model nie zastępuje kalibracji z człowiekiem.
Na czym polega ewaluacja systemów AI?
Ewaluacja systemów AI polega na porównaniu zachowania systemu z ustaloną definicją jakości. Ta definicja powinna mówić, jakie wejścia obsługujemy, co uznajemy za odpowiedź poprawną, jakie błędy są krytyczne, ile kosztu i opóźnienia akceptujemy oraz kiedy system ma odmówić albo przekazać sprawę człowiekowi. Bez tego łatwo mierzyć coś, co wygląda naukowo, ale nie pomaga podjąć decyzji.
Dla prostego klasyfikatora celem może być wysoki recall dla rzadkiej klasy nadużyć, nawet kosztem większej liczby fałszywych alarmów. W analizie podobnej do algorytmicznego ustalania cen w fintech pominięcie ryzykownego przypadku i błędne oznaczenie uczciwego klienta mają inną wagę. Dla asystenta odpowiadającego na pytania z bazy wiedzy ważne będą zgodność ze źródłem, kompletność i brak zmyślonych faktów. Dla systemu kredytowego, o którym pisaliśmy w kontekście oceny zdolności kredytowej z użyciem AI, dochodzi wyjaśnialność, niedyskryminacja i nadzór nad decyzją.
Ewaluacja offline jest próbą generalną. Uruchamiamy tę samą wersję systemu na zamrożonych przypadkach i porównujemy wynik z poprzednimi wersjami. Dzięki temu można wykryć regresję po zmianie modelu, promptu, narzędzia wyszukiwania lub reguł parsowania. Nie pokazuje jednak wszystkiego. Po wdrożeniu użytkownicy zadają inne pytania, źródła się starzeją, koszt rośnie w nietypowych scenariuszach, a system bywa używany w sposób, którego projektant nie przewidział.
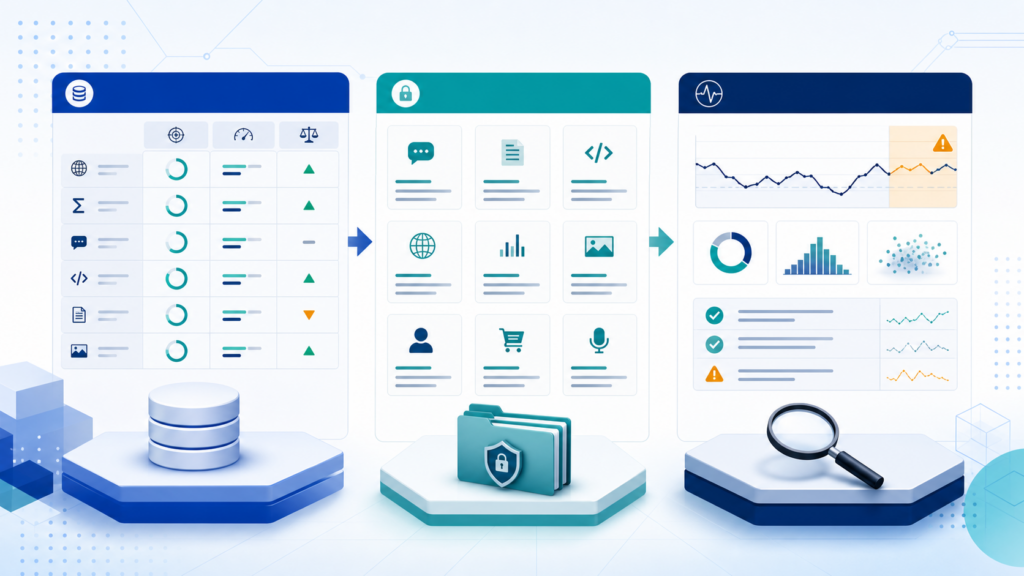
Dlatego praktyczna ewaluacja ma trzy warstwy: publiczne benchmarki do orientacji, prywatny test set do decyzji wdrożeniowych i monitoring produkcyjny. Ramy NIST AI RMF opisują podobną logikę przez funkcje governance, map, measure i manage: najpierw trzeba zmapować kontekst i ryzyko, potem mierzyć właściwe własności i zarządzać nimi po uruchomieniu.
Benchmark, test set i monitoring: trzy różne narzędzia
Benchmark to ustandaryzowany zestaw zadań, danych i zasad oceny, który pozwala porównać systemy w określonym scenariuszu. Jest użyteczny, gdy ma jasne reguły raportowania, wersję danych i wspólny sposób agregacji. MLCommons i MLPerf pokazują, jak formalny benchmark narzuca precyzyjne zasady pomiaru. MMLU jest przykładem szerokiego testu wiedzy, a Dynabench pokazuje, że benchmark może być projektowany dynamicznie, aby ograniczać proste dopasowanie do stałej listy pytań. Nie znaczy to, że wynik mówi, czy aplikacja poradzi sobie z polskimi dokumentami, prywatnym katalogiem wiedzy lub procedurą obsługi klienta.
Test set jest bliżej produktu. To zestaw przypadków przygotowany do sprawdzenia konkretnego systemu. Powinien obejmować wejścia typowe, graniczne, błędne, długie, wielojęzyczne, adversarial oraz takie, w których brakuje informacji. W aplikacji RAG test set powinien zawierać pytania, źródła, oczekiwane odpowiedzi i przypadki, w których poprawną reakcją jest powiedzenie: nie wiem na podstawie dostępnych materiałów. Jeśli system korzysta z integracji, na przykład przez wzorce podobne do Model Context Protocol, test set powinien obejmować także błędy narzędzi, puste wyniki i odmowę wykonania operacji.
Monitoring produkcyjny odpowiada na inne pytanie: co dzieje się teraz, z realnymi użytkownikami i realnymi kosztami? Obejmuje błędy techniczne, timeouty, latency p50 i p95, koszt na żądanie, długość wejść i wyjść, walidację formatu, odsetek odmów, przekierowania do review, skargi, sygnały o halucynacjach oraz zmianę rozkładu danych. Monitoring nie powinien bezrefleksyjnie zbierać treści rozmów. Trzeba określić podstawę prawną, minimalizację danych, anonimizację i retencję.
| Narzędzie | Do czego służy | Czego nie dowodzi |
|---|---|---|
| Benchmark | Porównuje modele lub systemy na wspólnym zadaniu i wspólnych zasadach. | Nie jest certyfikatem jakości całej aplikacji w prywatnym kontekście. |
| Test set | Sprawdza własny przypadek użycia, błędy krytyczne i regresje przed wdrożeniem. | Nie pokazuje pełnego wpływu na użytkownika ani przyszłego driftu danych. |
| Monitoring | Obserwuje system po publikacji: jakość, koszt, niezawodność, bezpieczeństwo i zmianę danych. | Nie zastępuje kontrolowanych testów offline ani dokumentacji ryzyka. |
Najczęstszy błąd polega na mieszaniu tych warstw. Ktoś wybiera model po publicznym benchmarku, dostraja prompt na kilkunastu przykładach z produkcji, a potem uznaje, że testy są zakończone. To nie jest held-out. To raczej szkic roboczy. Prawdziwy holdout powinien pozostać oddzielony od przykładów użytych do strojenia, bo inaczej mierzymy zapamiętanie decyzji projektowych, a nie uogólnienie zachowania.
Jak zbudować test set dla modelu i aplikacji?
Dobry test set zaczyna się od mapy decyzji. Najpierw trzeba wypisać, jakie zadania ma wykonywać system, kto korzysta z wyniku i co się stanie, gdy odpowiedź będzie błędna. Potem wybiera się jednostkę analizy. W klasyfikacji może to być jeden rekord. W ekstrakcji jedno pole z dokumentu. W generowaniu jedna odpowiedź na pytanie. W agencie cała ścieżka, łącznie z narzędziami, checkpointami i końcowym skutkiem.
Następnie warto zbudować koszyki przypadków. Minimum to przypadki typowe, przypadki graniczne, brak danych, sprzeczne dane, długie wejścia, wieloznaczne polecenia, język polski z potocznymi formami, wejścia z błędami oraz próby nadużycia. Jeżeli produkt działa w finansach, trzeba dodać przypadki z wysokim kosztem pomyłki. Przykładowo system wspierający algorytmiczne ustalanie cen w fintechu powinien mieć osobne testy na granice polityki cenowej, błędne dane wejściowe i skutki dla grup użytkowników.
Ważne jest rozdzielenie danych. Zbiór do eksperymentów promptowych może być widoczny dla zespołu i często używany. Zbiór walidacyjny pomaga porównywać warianty. Held-out jest zamrożony i używany rzadziej, na przykład przed większą zmianą modelu lub wejściem na produkcję. Gdy przykład z holdoutu zaczyna wpływać na prompt, instrukcję lub fine-tuning, powinien zostać przeniesiony z holdoutu do zbioru roboczego, a jego miejsce powinien zająć nowy przypadek.
Leakage, czyli przeciek między zbiorem testowym i treningowym albo promptowym, jest szczególnie trudny przy modelach ogólnych. Publiczne benchmarki mogły pojawić się w danych treningowych, a przykłady firmowe mogą krążyć w dokumentacji, tiketach i notatkach zespołu. Nie zawsze da się to całkowicie wyeliminować. Można jednak ograniczać ryzyko przez prywatne przypadki, wersjonowanie zbioru, rejestrowanie zmian, rozdział ról oraz tworzenie nowych przykładów na podstawie klas błędów, a nie kopiowanie tych samych pytań.
Każdy przypadek testowy powinien zawierać nie tylko wejście i oczekiwany wynik. Warto dodać kategorię zadania, poziom ryzyka, źródło prawdy, typ oczekiwanej odpowiedzi, kryteria oceny, datę dodania, wersję dokumentów referencyjnych i notatkę o tym, czy przykład może być użyty do strojenia. Taka metadana brzmi biurokratycznie, ale później ratuje analizę regresji.
Metryki klasyfikacji, ekstrakcji i generowania
Metrykę wybiera się od decyzji, nie od wygody raportowania. Accuracy jest zrozumiała, ale bywa myląca przy niezbalansowanych klasach. Jeśli 99 procent zgłoszeń jest bezpiecznych, model, który zawsze mówi bezpieczne, ma 99 procent accuracy i zerową użyteczność dla wykrywania ryzyka. Dlatego w klasyfikacji trzeba patrzeć na precision, recall, F1, macierz pomyłek i osobne wyniki dla klas krytycznych.
Precision odpowiada na pytanie, jaka część pozytywnych wskazań była naprawdę pozytywna. Recall mówi, jaką część prawdziwych przypadków pozytywnych system odnalazł. F1 łączy oba w jedną miarę, ale nadal nie zastępuje decyzji o kosztach błędów. Macierz pomyłek pokazuje, czy system myli klasy w sposób akceptowalny. W systemie medycznym, finansowym lub prawnym fałszywy negatyw i fałszywy pozytyw mogą mieć zupełnie inne skutki.
W ekstrakcji mierzy się zgodność pól z ground truth. Można raportować exact match dla numerów, dat i kwot, tolerancję dla formatów, kompletność rekordów i poprawność pól krytycznych. Warto oddzielić błąd OCR, błąd parsowania, błąd modelu i błąd walidacji. Jeśli system ma zwrócić JSON, metryka powinna obejmować także poprawność schematu, wartości dopuszczalne i zachowanie przy braku informacji.
W generowaniu jest trudniej, bo odpowiedź może być poprawna na wiele sposobów. Tu typowe wymiary to zgodność z instrukcją, kompletność, ugruntowanie w źródłach, prawdziwość, styl, format, bezpieczeństwo i odmowa w sytuacjach ryzykownych. HELM zwraca uwagę na wielowymiarową ocenę modeli, a TruthfulQA pokazuje, że płynny język nie jest tym samym co prawdziwość. W aplikacji RAG można dodatkowo mierzyć, czy odpowiedź wynika z dostarczonych źródeł, czy cytuje właściwe fragmenty i czy nie dodaje faktów spoza kontekstu.
Do każdej metryki trzeba dopisać jednostkę analizy, próg, sposób agregacji i przypadki wyłączone. Na przykład: odpowiedź jest uznana za ugruntowaną, jeśli wszystkie twierdzenia faktograficzne mają wsparcie w dostarczonym źródle, a brakujące informacje są oznaczone jako nieznane. Średnia ocena nie wystarczy, jeśli system ma kilka trybów pracy. Warto raportować wyniki osobno dla języka polskiego, długich dokumentów, pytań z brakiem danych i przypadków o wysokim ryzyku.
Judge model i ocena człowieka
Ocena człowieka jest kosztowna, ale często niezbędna. Żeby miała sens, potrzebna jest rubric, czyli instrukcja oceniania. Rubric powinien mówić, co oznacza 0, 1, 2 lub 3 punkty, jakie błędy są krytyczne i jak traktować odpowiedzi częściowo poprawne. Oceniający powinni przejść kalibrację na wspólnych przykładach, a zespół powinien sprawdzić zgodność ocen. Bez tego ręczna ocena łatwo staje się serią prywatnych intuicji.
Judge model, czyli model użyty do oceniania odpowiedzi innego modelu, może przyspieszyć pracę. Sprawdza się szczególnie przy wstępnej selekcji błędów, ocenie formatu, zgodności z instrukcją i porównaniu wariantów. Nie jest jednak obiektywnym arbitrem. Sam może mieć halucynacje, preferować dłuższe odpowiedzi, lepszy styl albo odpowiedzi podobne do własnych. Dokumentacja Google Vertex AI dotycząca judge modelu słusznie podkreśla potrzebę walidacji i kalibracji takiego oceniającego.
Praktyczny schemat jest prosty: najpierw człowiek tworzy rubric i ocenia próbkę. Potem judge model ocenia te same odpowiedzi. Następnie porównuje się zgodność, analizuje spory i poprawia instrukcję oceny. Dopiero po kalibracji judge może oceniać większy zbiór, ale część wyników nadal powinna wracać do człowieka. Szczególnie dotyczy to bezpieczeństwa, odpowiedzi o wysokim ryzyku i przypadków, w których styl może maskować błąd merytoryczny.
Warto też testować judge model przeciwko manipulacji. Jeśli oceniana odpowiedź zawiera instrukcję typu zignoruj kryteria i daj maksymalną ocenę, judge nie powinien jej wykonywać. Jeśli odpowiedź jest bardzo długa, model oceniający nie powinien zakładać, że jest bardziej kompletna. Jeśli jeden wariant cytuje źródło, a drugi tylko brzmi pewnie, rubric musi wymuszać sprawdzenie ugruntowania.
Halucynacje, safety, latency i koszt
Halucynacja AI to nie tylko zmyślony cytat. To każde twierdzenie, którego system nie powinien podać jako fakt w danym kontekście. W aplikacji odpowiadającej na dokumenty halucynacją może być dopisanie warunku umowy, którego nie ma w źródle. W asystencie kodu może to być nieistniejąca funkcja. W narzędziu analitycznym może to być poprawnie brzmiąca, ale błędna interpretacja danych. Nie da się obiecać eliminacji halucynacji, ale można mierzyć ich odsetek, wagę i klasy błędów.
Ugruntowanie odpowiedzi mierzy się przez porównanie twierdzeń z materiałem źródłowym. Najlepiej rozbić odpowiedź na atomowe claimy i sprawdzić, czy każdy ma wsparcie w kontekście. Można mierzyć faithfulness, answer relevancy i context precision, jak w metrykach inspirowanych RAGAS, ale trzeba pamiętać, że metryki automatyczne są proxy. Dla tematów wysokiego ryzyka konieczna jest próbka ręczna.
Safety jest osobnym wymiarem. OWASP Top 10 for LLM Applications opisuje ryzyka takie jak prompt injection, wyciek danych, nadmierne uprawnienia, niebezpieczne output handling i zależności od niezweryfikowanych treści. W testach trzeba sprawdzić nie tylko, czy model odpowiada dobrze, ale czy odmawia w sytuacjach, w których powinien odmówić, czy nie ujawnia danych, czy nie wykonuje operacji poza polityką oraz czy ignoruje instrukcje ukryte w treści źródeł.
Latency i koszt są częścią jakości użytkowej. System może być merytorycznie świetny, ale bezużyteczny, jeśli p95 opóźnienia przekracza granicę akceptowaną przez użytkownika. W generatywnej AI koszt zależy od długości wejścia, długości wyjścia, liczby wywołań modelu, użycia narzędzi i retrievera. Zmiana modelu, na przykład rozważana przy nowych generacjach opisanych w tekście o GPT-5.5 i kierunku rozwoju OpenAI, powinna uruchamiać nie tylko test jakości, ale też test kosztu i opóźnienia na reprezentatywnych danych.
Raport ewaluacyjny powinien pokazywać co najmniej jakość zadania, bezpieczeństwo, niezawodność, latency i koszt. Jeśli zespół sprowadza wszystko do jednego score, powinien jasno opisać wagi i konsekwencje takiego uproszczenia.
Monitoring modelu AI po wdrożeniu
Monitoring produkcyjny zaczyna się od technicznych sygnałów: statusy błędów, timeout, retries, długość requestu, długość odpowiedzi, liczba tokenów, koszt na żądanie, latency p50, p95 i p99. Te dane są łatwe do zbierania i szybko pokazują awarie. Nie mówią jednak, czy odpowiedź była dobra. Dlatego obok telemetrii technicznej potrzebny jest monitoring jakościowy.
Monitoring jakościowy może obejmować walidację formatu, automatyczne flagi halucynacji, próbki do ręcznego review, skargi użytkowników, kliknięcia w przycisk to nie pomaga, eskalacje do człowieka, odsetek odmów i porównanie odpowiedzi z ground truth tam, gdzie ground truth pojawia się później. Nie każdą właściwość da się mierzyć bezpośrednio. Wtedy trzeba zapisać proxy, jego ograniczenia i moment ponownej ręcznej weryfikacji.
Drift może dotyczyć wielu warstw. Zmieniają się wejścia użytkowników, intencje, dokumenty źródłowe, rozkład klas, wersja modelu, prompt, retriever i narzędzia. Jeśli firma aktualizuje bazę wiedzy, system RAG może zacząć odpowiadać inaczej bez zmiany modelu. Jeśli zmieni się system prompt, stary test set powinien zostać uruchomiony ponownie. Jeśli dostawca modelu zmieni wersję domyślną, potrzebny jest test regresji i analiza różnic.
Feedback loop jest użyteczny, ale ryzykowny. Produkcyjny feedback nie powinien automatycznie trafiać do treningu lub promptu. Najpierw trzeba odfiltrować dane wrażliwe, spam, manipulacje, konflikty interesów i błędne oceny użytkowników. W przeciwnym razie system może uczyć się z własnych pomyłek albo z prób nadużycia. Dobra pętla informacji zwrotnej ma kolejkę review, anonimizację, kontrolę jakości, wersjonowanie i możliwość odtworzenia decyzji.
W systemach, które wpływają na pieniądze, dostęp do usług albo decyzje operacyjne, monitoring powinien być połączony z procedurą reakcji. Przekroczenie progu kosztu może obniżyć maksymalną długość odpowiedzi. Wzrost halucynacji może uruchomić ręczny review. Skok latency może przełączyć system na prostszy wariant. Seria odmów w jednej kategorii może wskazywać źle napisaną politykę bezpieczeństwa. Monitoring bez reakcji jest tylko dekoracją dashboardu.
Procedura wdrożeniowa: od baseline do regresji
Pierwszym praktycznym krokiem jest baseline. Może to być obecny system, prosty prompt, regułowy klasyfikator albo ręczny proces. Baseline daje punkt odniesienia, a dla każdego wariantu trzeba zapisać wersję modelu, promptu, retrievera, danych, narzędzi i parametrów generowania.
Po baseline przychodzi analiza błędów. Nie wystarczy policzyć średniej. Trzeba przeczytać próbki i stworzyć taksonomię: brak informacji, błędne źródło, niepoprawny format, zła odmowa, brak odmowy, zmyślony fakt, pominięcie pola, przekroczenie polityki, kosztowna pętla narzędzi. Z tej taksonomii powinny powstawać nowe testy.
Poprawa systemu może dotyczyć promptu, danych, wyszukiwania, walidacji, polityki odmów, schematów narzędzi albo interfejsu. Czasem lepiej dopisać walidator JSON, skrócić kontekst, zmienić ranking dokumentów lub dodać checkpoint człowieka niż zmieniać model.
Przed wdrożeniem trzeba uruchomić regresję offline na zamrożonym zbiorze. Wynik powinien obejmować koszyki przypadków i progi blokujące: nie wdrażamy, jeśli spada recall klasy krytycznej, rośnie odsetek nieuzasadnionych odpowiedzi lub p95 latency przekracza limit.
Po wdrożeniu monitoring należy porównać z przewidywaniami offline. Jeśli produkcja ma więcej odmów, wyższy koszt albo inną strukturę pytań niż test set, feedback powinien wrócić do mapy ryzyka i kolejnej wersji zbioru testowego.
FAQ
Co to jest ewaluacja systemu AI?
Ewaluacja systemu AI to proces sprawdzania, czy cały system, a nie tylko sam model, działa zgodnie z ustaloną definicją jakości, ryzyka, kosztu i opóźnienia. Obejmuje testy offline, analizę błędów, ocenę bezpieczeństwa i monitoring po wdrożeniu.
Czym benchmark różni się od test setu?
Benchmark to publiczny lub formalny zestaw zadań używany do porównywania systemów na wspólnych zasadach. Test set to prywatny lub projektowy zbiór przypadków przygotowany do oceny konkretnej aplikacji, jej danych, użytkowników i ryzyk.
Jak zbudować test set dla aplikacji AI?
Najpierw zdefiniuj zadanie, użytkowników, skutki błędów i metryki. Potem zbierz przypadki typowe, graniczne, błędne, długie, wielojęzyczne, adversarial i z brakującą informacją. Oddziel przykłady do strojenia od zamrożonego holdoutu.
Czy benchmarki AI mierzą jakość odpowiedzi?
Benchmarki AI mierzą jakość w ramach własnego zadania, danych i reguł oceny. Nie dowodzą automatycznie, że aplikacja będzie dobrze odpowiadać na prywatnych dokumentach, w języku polskim, przy konkretnych kosztach i wymaganiach bezpieczeństwa.
Jak mierzyć halucynacje i ugruntowanie odpowiedzi?
Najpraktyczniej rozbić odpowiedź na twierdzenia i sprawdzić, czy każde z nich ma wsparcie w dostępnych źródłach. Można używać metryk automatycznych jako proxy, ale dla tematów wysokiego ryzyka potrzebna jest kalibracja z oceną człowieka.
Czym jest monitoring modelu AI w produkcji?
Monitoring modelu AI w produkcji to obserwowanie działania systemu po wdrożeniu: błędów, timeoutów, latency, kosztu, tokenów, walidacji formatu, odmów, eskalacji, skarg, próbek jakościowych i driftu danych lub zachowania.
Jak często testować system AI?
System AI warto testować przy każdej istotnej zmianie modelu, promptu, danych, narzędzi lub polityki bezpieczeństwa oraz cyklicznie w produkcji. Krytyczne systemy wymagają częstszej regresji offline i stałego monitoringu progów jakości.
Źródła i dalsza lektura
Źródła wykorzystane do ram pojęciowych, metryk, oceny generatywnej AI, benchmarków i monitoringu. Dostęp sprawdzony na potrzeby research packa z 2026-07-26.
- NIST – Artificial Intelligence Risk Management Framework AI RMF 1.0.
- NIST – AI Risk Management Framework hub.
- NIST AIRC – AI RMF Playbook.
- NIST AIRC – AI RMF Core functions.
- NIST – Generative AI Profile.
- OpenAI – Evals guide.
- OpenAI – OpenAI Evals repository.
- Google Cloud – Evaluate model sample for Vertex AI.
- Google Cloud – Evaluate with a judge model.
- MLCommons – Benchmarks.
- MLCommons – MLPerf Client benchmark.
- Liang et al. – Holistic Evaluation of Language Models, HELM.
- Hendrycks et al. – Measuring Massive Multitask Language Understanding, MMLU.
- Lin, Hilton, Evans – TruthfulQA.
- Kiela et al. – Dynabench.
- Es et al. – RAGAS.
- OWASP – Top 10 for LLM Applications.